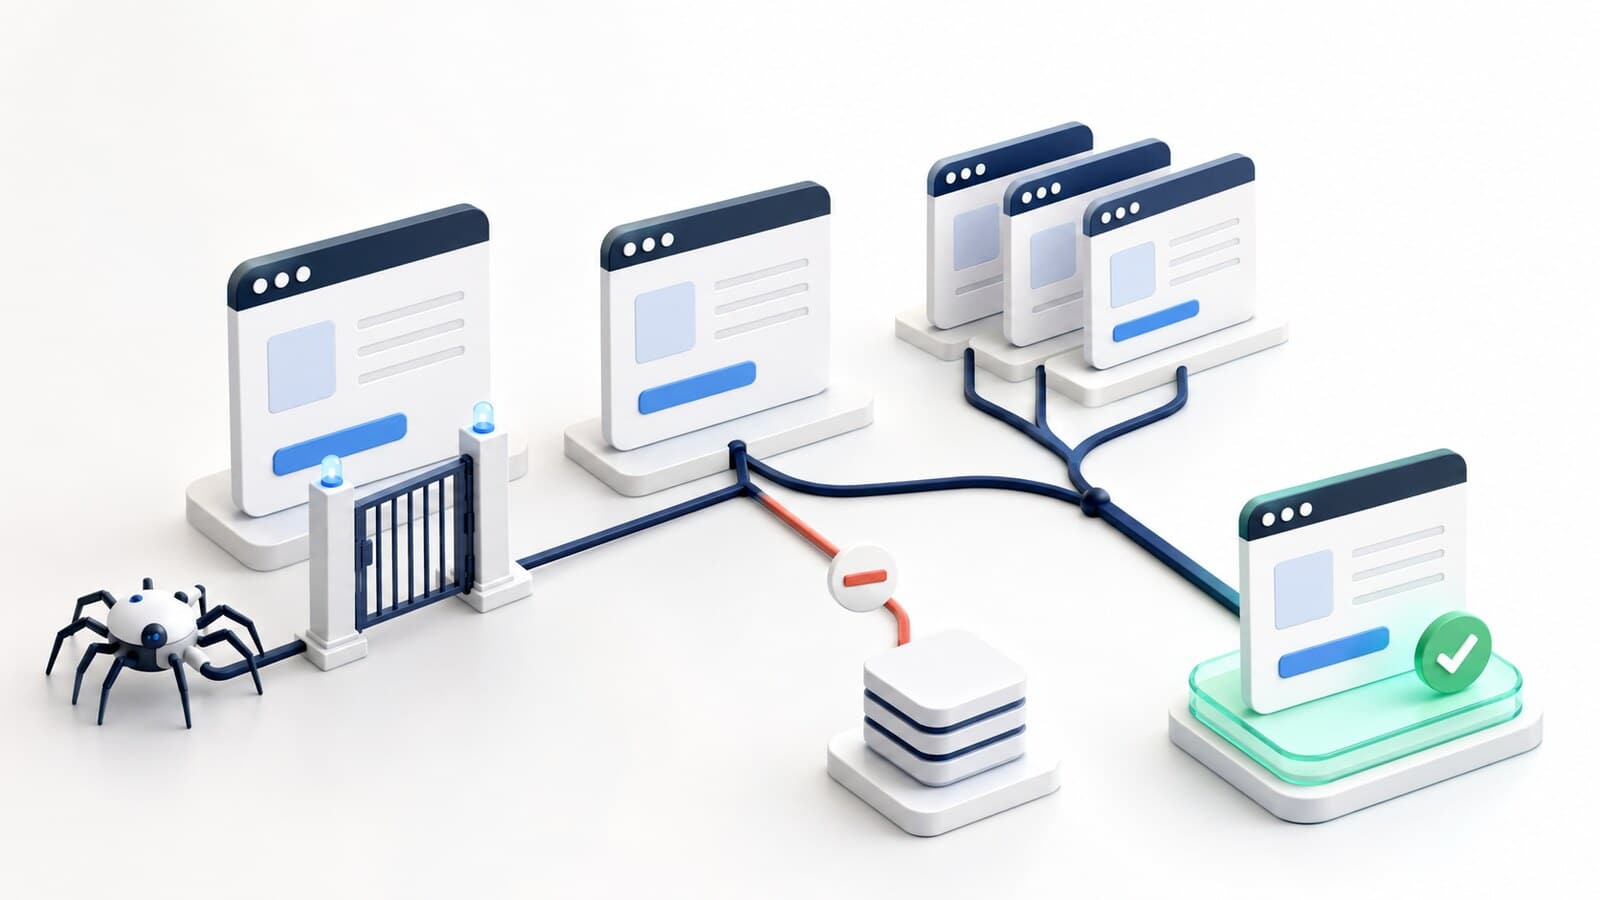
Важна страница може да изчезне от Google само заради една грешна настройка. В друг случай търсачката показва адрес с параметри вместо основната страница. Понякога тестова или служебна страница остава видима в резултатите, въпреки че е забранена в robots.txt.
Причината често е смесването на три различни механизма:
noindex указва, че достъпна страница не трябва да се показва в резултатите;Те не са взаимозаменяеми. Преди промяна трябва да се реши какво искате да се случи с конкретния URL: да остане в Google, да бъде изключен от резултатите, да се обедини с друга версия или да стане недостъпен за външни лица.
| Механизъм | Какво прави | Какво не прави |
|---|---|---|
| robots.txt | Ограничава обхождането на определени адреси или групи адреси | Не премахва надеждно уеб страница от Google и не пази поверителни данни |
noindex | Изключва достъпна страница или файл от резултатите, след като търсачката прочете указанието | Не избира друга страница за предпочитана и не ограничава достъпа на хора |
| canonical | Подсказва коя версия е предпочитана при еднакво или много сходно съдържание | Не забранява обхождането и не е безусловна команда |
Най-краткото практично правило е следното:
noindex за контрол на присъствието в резултатите;| Желан резултат | Подходящо решение | Основен риск за проверка |
|---|---|---|
| Страницата трябва да се показва в Google | Разрешено обхождане и canonical към самия адрес | Картата на сайта и вътрешните връзки трябва да сочат към същия URL |
| Страницата трябва да остане достъпна, но да не се показва в Google | noindex | robots.txt не трябва да пречи на търсачката да прочете указанието |
| Дублирана версия трябва да се обедини с основната | Canonical към предпочитания URL | Страниците трябва да са еднакви или много сходни |
| Стар адрес е заменен окончателно | Постоянно пренасочване към точния заместител | Canonical не замества пренасочването за потребителите |
| Страницата съдържа поверителна информация | Вход с парола или друго реално ограничение на достъпа | robots.txt и noindex не са защита |
| PDF не трябва да се показва в Google | X-Robots-Tag: noindex в HTTP отговора | Указанието трябва да присъства в отговора на самия файл |
Тази таблица е отправна точка, а не универсална настройка за целия сайт. При категории, филтри, езикови версии и голям брой параметри първо се разглеждат групите адреси и тяхната бизнес функция.
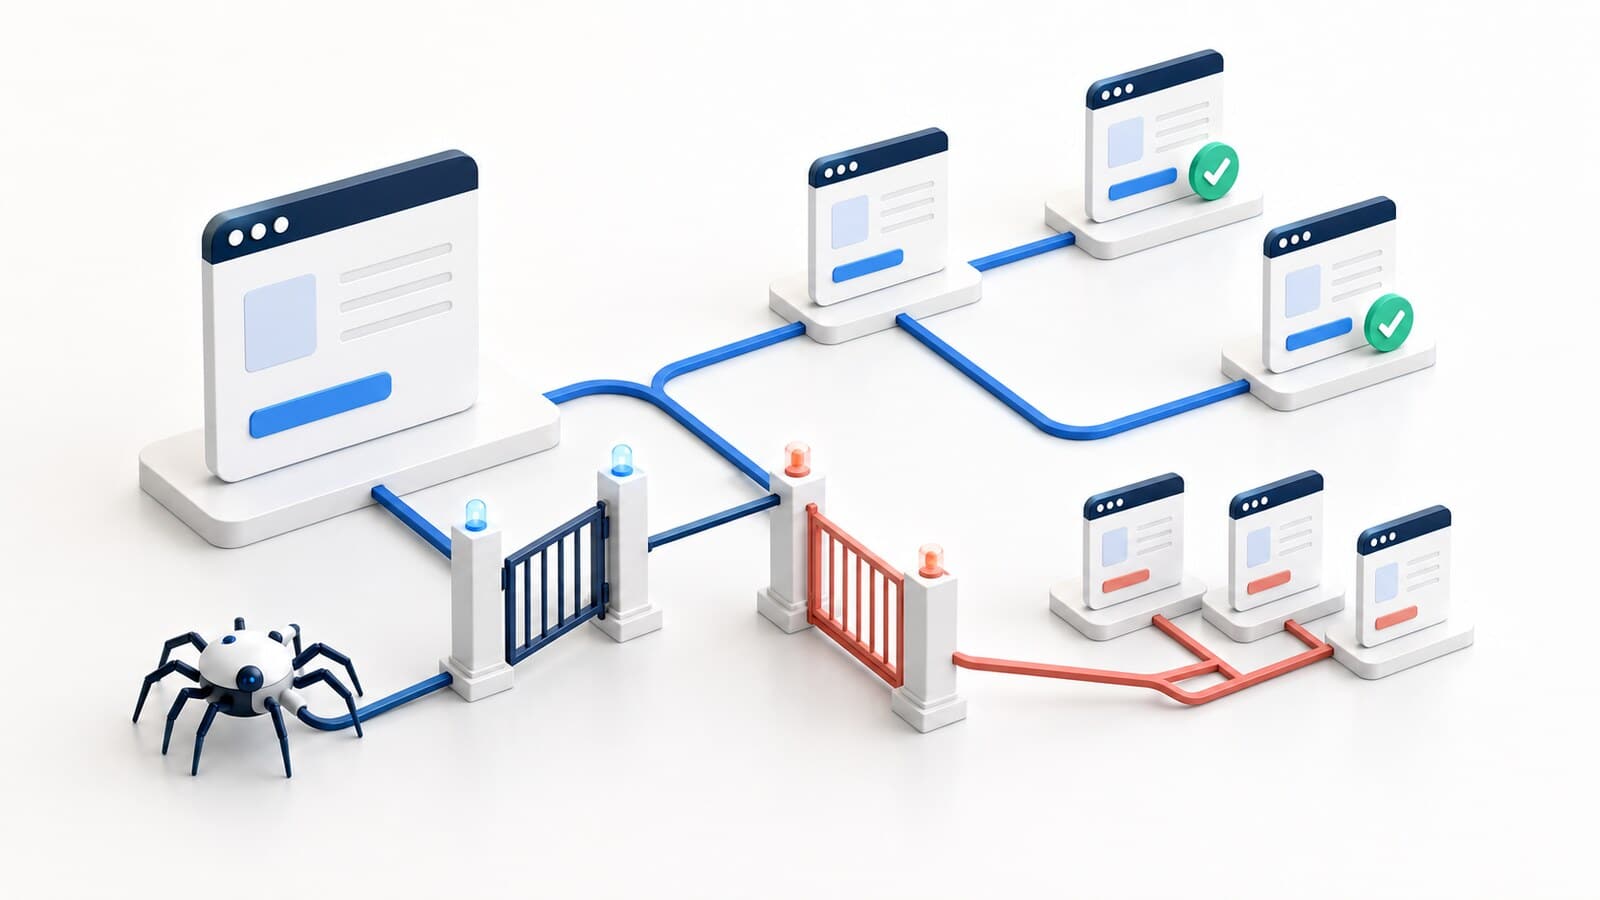
Robots.txt е публичен текстов файл в основната директория на сайта, например:
https://example.com/robots.txt
Едно правило може да изглежда така:
User-agent: *
Disallow: /internal-search/
С него се указва на търсачките да не обхождат адреси, които започват с /internal-search/. Това може да е полезно при безкрайни комбинации от технически адреси или секции без стойност за търсенето.
Google обаче изрично посочва, че robots.txt служи основно за управление на трафика от роботи, а не за премахване на уеб страници от резултатите. Ако други страници сочат към забранен URL, Google може да знае за него и да покаже адреса без нормално описание. Това ограничение е описано в официалното ръководство за robots.txt.
Robots.txt не трябва да се използва за:
Ако съдържанието не трябва да е публично, ограничете реалния достъп с вход, парола, мрежово правило или друга подходяща защита. Файлът robots.txt е видим за всеки и сам по себе си не спира човек, който знае адреса.
Внимавайте и с блокирането на CSS и JavaScript файлове. Когато те са необходими за основното съдържание или навигацията, Google може да получи непълна версия на страницата.
Noindex е указание към търсачката да не показва дадена страница в резултатите. За HTML страница обичайният вариант е:
<meta name="robots" content="noindex">
Критичното условие е страницата да бъде достъпна за обхождане. Ако URL адресът е забранен в robots.txt, Googlebot няма да стигне до страницата и няма да прочете noindex. Google описва това условие директно в документацията за noindex.
Следователно тази комбинация е конфликтна:
robots.txt: Disallow
страница: noindex
Правилната последователност е:
noindex в HTML или HTTP отговора;Noindex може да е подходящ за вътрешни резултати от търсене, благодарствени страници след форма или публично достъпни служебни страници без самостоятелна стойност в Google. Той не е добра реакция само защото една страница временно няма трафик или се класира по-слабо. В такъв случай първо трябва да се установи дали страницата е полезна, дали има точен заместител и дали проблемът е в съдържанието или в техническата настройка.
PDF и други файлове нямат HTML поле, в което да се постави robots meta tag. За тях може да се използва HTTP заглавката X-Robots-Tag:
HTTP/1.1 200 OK
Content-Type: application/pdf
X-Robots-Tag: noindex
Google посочва X-Robots-Tag като подходящ начин за управление на индексирането на PDF, изображения и други файлове. Заглавката трябва да се проверява в реалния HTTP отговор, а не само чрез отваряне на файла в браузър. Подробностите са в официалната спецификация за robots meta и X-Robots-Tag.
Canonical е указание коя страница е предпочитаната версия при еднакво или много сходно съдържание. В HTML изглежда така:
<link rel="canonical" href="https://example.com/preferred-page/">
Типичен случай е продуктова или категорийна страница, която се отваря и с допълнителни параметри. Ако съдържанието по същество е същото, вариантите могат да сочат с canonical към чистия основен адрес.
Canonical е силен сигнал, но Google не е длъжен да го приеме. Официалното ръководство за canonical URL определя пренасочванията и rel="canonical" като силни сигнали, а включването в XML карта на сайта като по-слаб сигнал.
За да бъде изборът последователен:
Google препоръчва основната страница също да има canonical към самата себе си. Препоръчва се и използване на пълен абсолютен адрес с протокол и домейн, защото относителният адрес може по погрешка да посочи към тестова среда.
Canonical не е подходящ, когато двете страници са съществено различни. Не го използвайте и като заместител на постоянно пренасочване, когато старият адрес вече не трябва да се посещава.
| Конфликт | Възможна последица | Корекция |
|---|---|---|
robots.txt забранява адрес с noindex | Google не вижда noindex | Позволете обхождането, за да бъде прочетено указанието |
canonical сочи към страница с noindex | Предпочитаната страница е изключена от резултатите | Изберете достъпна страница, която може да участва в Google |
| canonical сочи към пренасочващ адрес | Създава се излишна междинна стъпка | Сочете директно към крайния работещ URL |
| XML картата съдържа дублираните адреси | Сайтът подава различни предпочитания | Оставете в картата само предпочитаните версии |
| Вътрешните връзки сочат към дублирани адреси | Сайтът подкрепя друга версия от посочената с canonical | Обновете връзките към предпочитания URL |
| canonical сочи към несходно съдържание | Google може да не приеме указанието | Запазете отделна страница или изберете действително сходен вариант |
Наличието на canonical към самата страница не отменя noindex. Ако един URL едновременно заявява, че е предпочитан, но и че не трябва да се показва, първо трябва да се реши каква е реалната му роля.
Не разчитайте само на настройката в разширението за SEO. Проверете крайния резултат, който сайтът връща.
X-Robots-Tag в HTTP отговора.Промяната на сайта не означава, че Google я е обработил веднага. Запишете датата на промяната, поискайте ново обхождане при необходимост и следете състоянието в отчета за индексирането. Допълнителните проверки в платформата са описани в ръководството за Google Search Console.
Единична неправилна настройка може да се поправи след проверка на конкретния URL. Когато обаче проблемът засяга категории, филтри, езикови версии, хиляди параметри или правила на ниво шаблон, отделната редакция не е достатъчна.
SEO одитът установява кои групи адреси са забранени, изключени от резултатите или свързани с неправилен canonical. Той показва и откъде идва конфликтът: robots.txt, HTML, HTTP отговор, XML карта, вътрешни връзки или настройка на системата. Резултатът е подреден списък с корекции според риска за важните страници.